Одна ошибка агента портит весь диалог: как найти шаг, который нужно исправить
Клиент уточняет запрос несколько раз, а агент продолжает работать с неверным исходным значением. Последний ответ выглядит логичным, хотя вся цепочка построена на ошибке. Оценка только финального сообщения покажет провал, но не объяснит, где он начался.
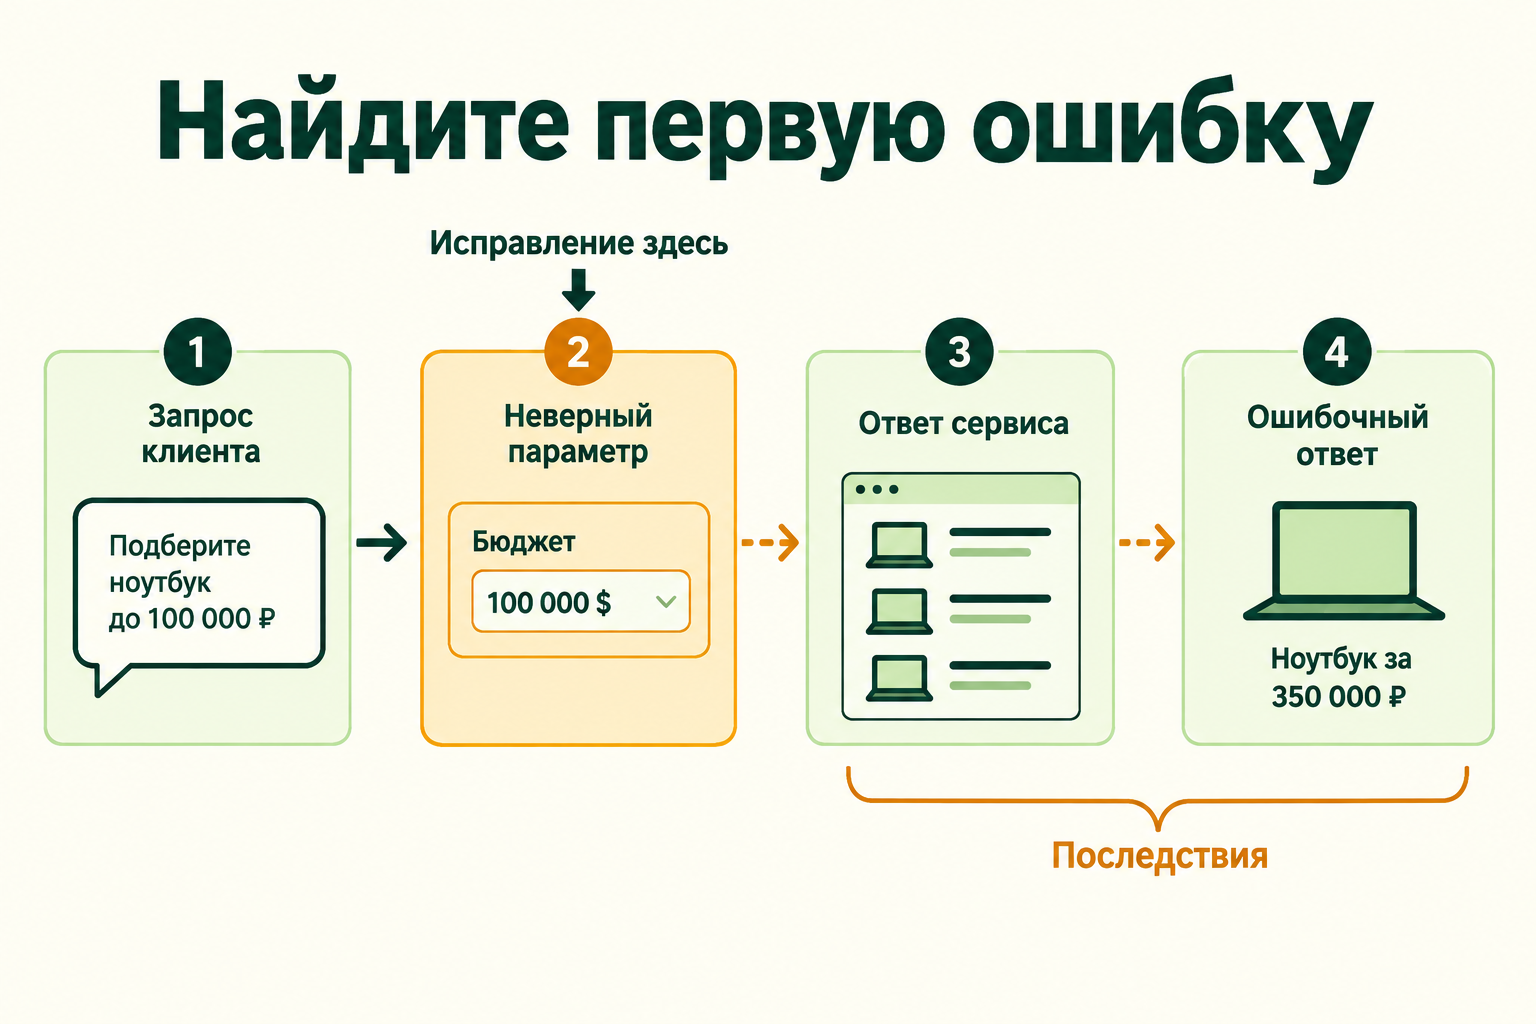
AWS 10 сентября представила подход Agent Evaluation Metric для проверки многошаговых диалогов. В описанной версии отдельно оцениваются достоверность и полнота каждого шага. Авторы различают исходную ошибку и последствия, которые унаследовали последующие действия.
Разберите диалог на проверяемые шаги
Рассмотрим подготовку коммерческого предложения. Сначала агент определяет клиента и нужный товар, затем получает условия, уточняет количество и собирает документ. Если на первом шаге выбран одноимённый контрагент, последующие расчёты могут быть правильными для другой компании.
Проверка каждого шага должна отвечать на два вопроса: все ли обязательные данные переданы и верны ли их значения. У вызова инструмента проверяются параметры. У ответа клиенту — утверждения, существенные условия и соответствие запросу.
Как организовать пилот
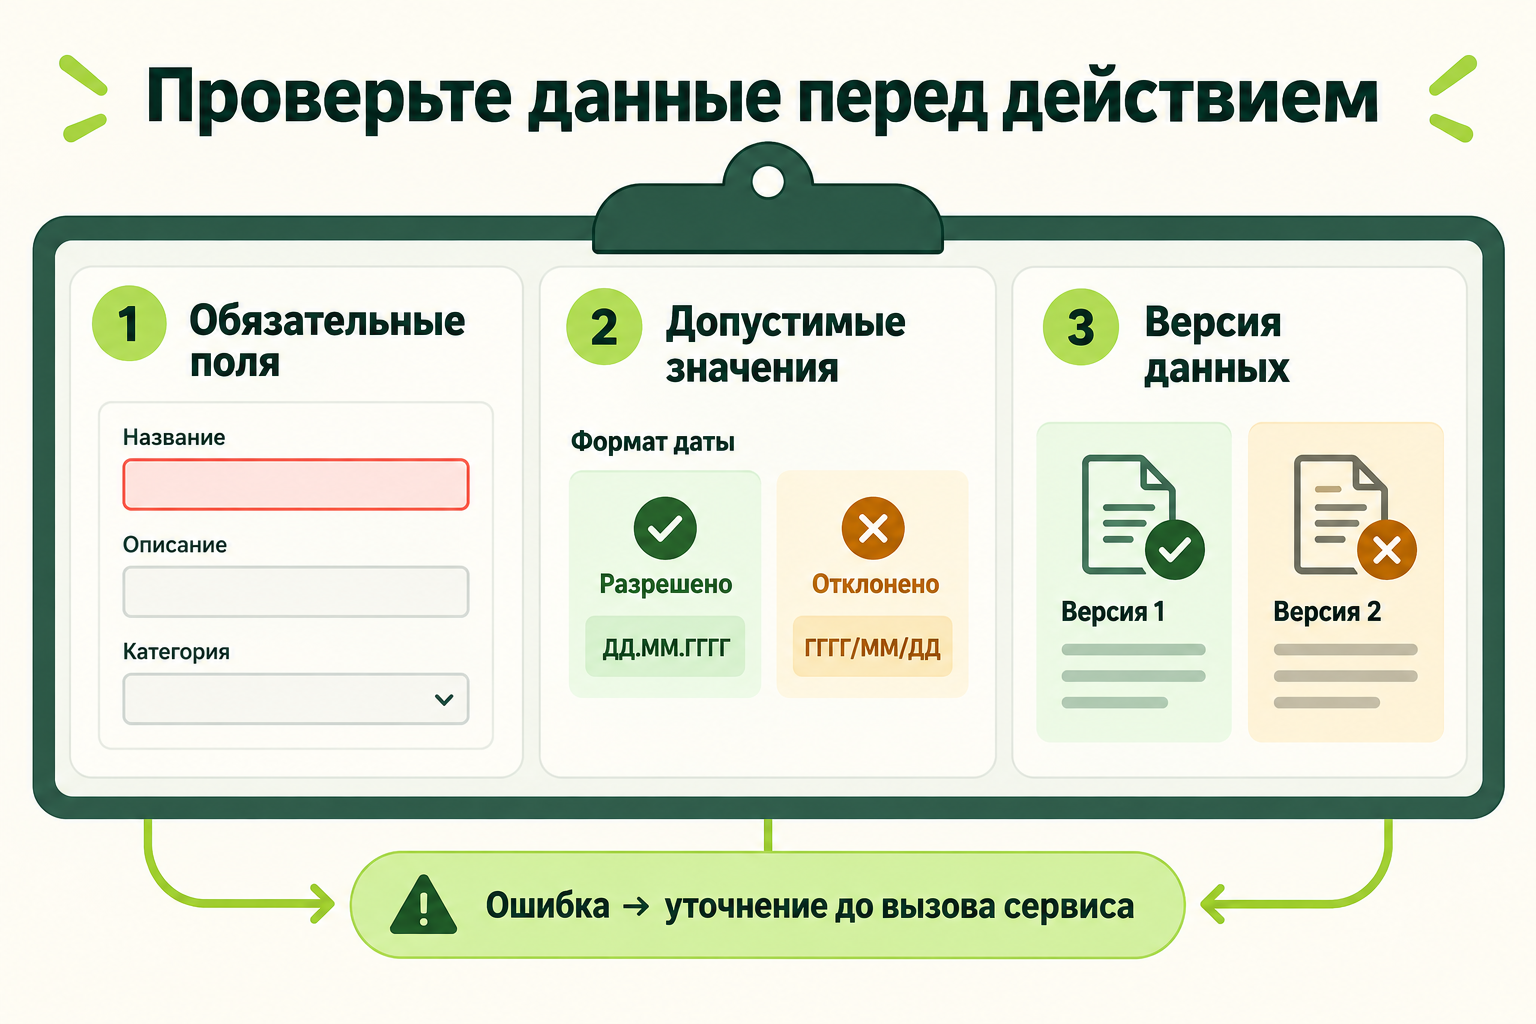
Соберите диалоги с уточнениями, исправлениями и сменой намерения. Для каждого отметьте допустимые действия, необходимые поля и момент, когда агент должен переспросить. Сохраняйте версию сценария и источник ожидаемого ответа.
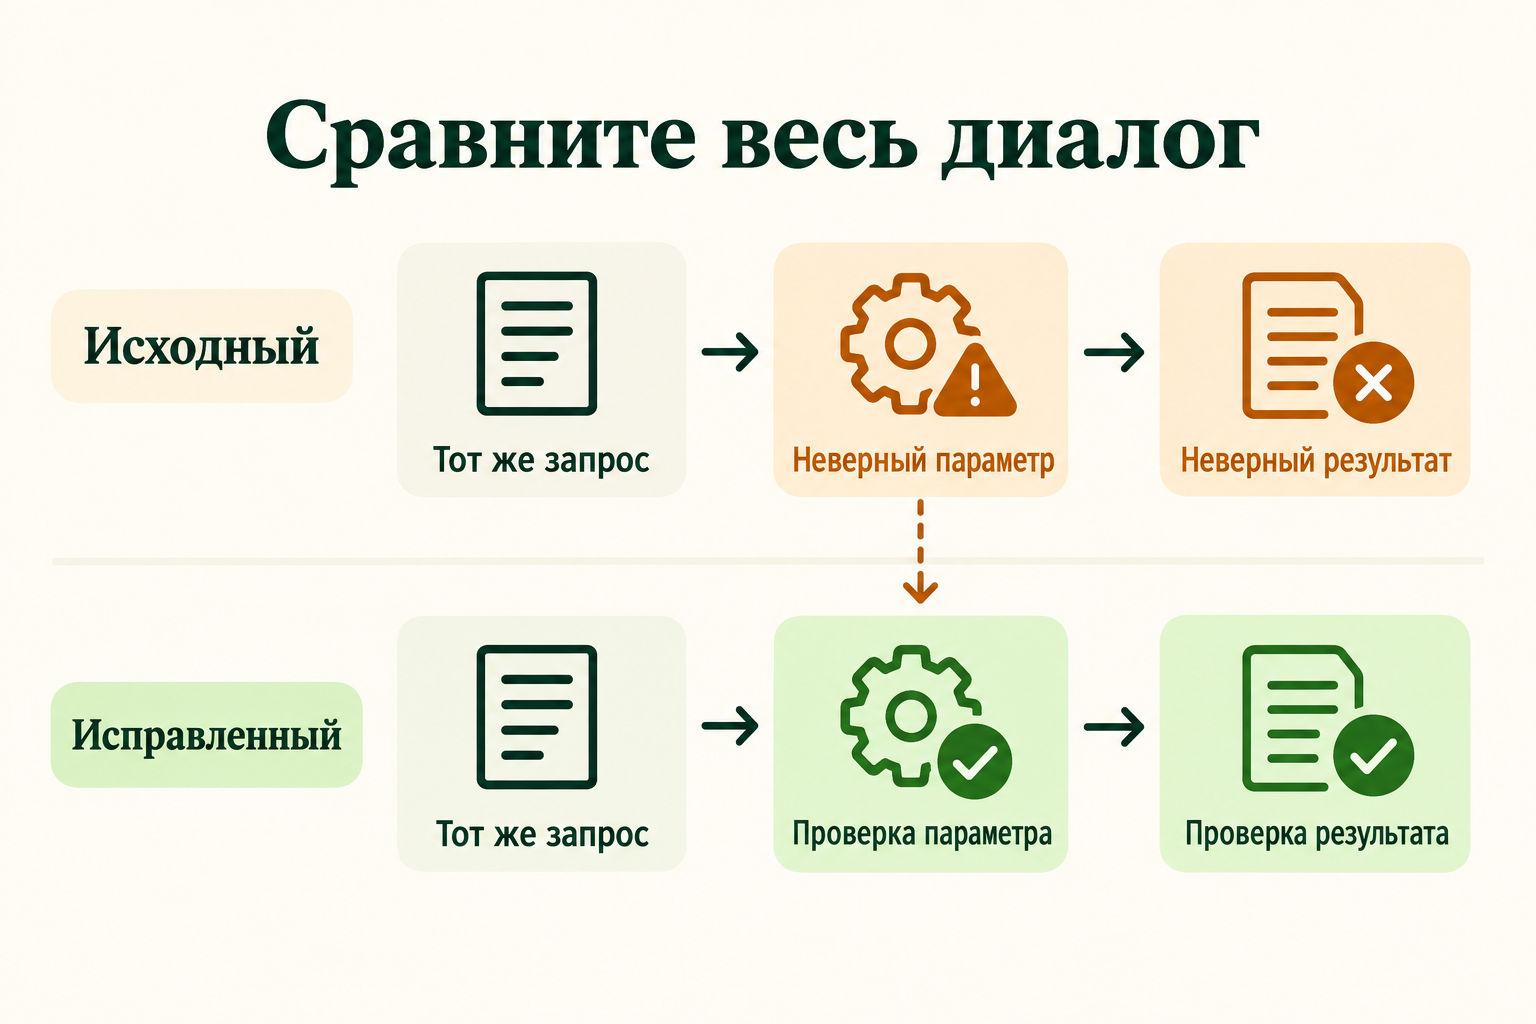
Если диалог закончился ошибкой, двигайтесь по цепочке до первого неверного шага. Исправление проверяйте на всей подборке: оно не должно ухудшить другие сценарии. Отдельно храните ситуации, где правильных формулировок несколько.
Принцип связывания шагов пригодится и в управлении проектами и задачами с ИИ: неверный исполнитель в начале цепочки влияет на сроки, уведомления и итоговый отчёт.
Риски пилота и условия масштабирования
Сравнение похожести текста может принять разные суммы или товары за эквивалентные. Идентификаторы, количество и денежные поля проверяйте по правилам и данным системы. Смысловую оценку оставьте для свободного текста.
Неполный эталон заставит оценку штрафовать допустимое уточнение. Привлекайте владельца процесса к разметке спорных случаев. Критерий готовности — согласованная оценка обязательных полей и устойчивое обнаружение первого сбоя.
В отчёте показывайте отдельно незавершённые диалоги, исходные ошибки и их последствия. Тогда команда сможет исправлять причину, а руководитель — оценивать изменение качества после выпуска новой версии.
Видео: Разбор ошибок и повторов в n8n
Автор канала «AI на твоей службе» показывает, как разбирать ошибки отдельных шагов и настраивать повторные попытки. В рабочем диалоге после исправления также нужно проверить весь путь до результата.